English
 Español
 Português (Brasil)
 Français
 Deutsch
 Italiano
 Nederlands
 Polski
 Svenska
 Türkçe
 Русский
 日本語
 한국어
 简体中文
 Tiếng Việt
 Bahasa Indonesia
 Čeština
 Dansk
 Norsk (bokmål)
 Suomi
 Ελληνικά
 Română
 Magyar
 Українська
 ไทย
 हिन्दी
 العربية
 עברית
觀察到的原生廣告創意佔比:計算與限制
你看不到競爭對手的原生廣告花費,但你可以計算每個廣告主在界定樣本中捕獲創意記錄的佔比,記錄加權方式與覆蓋範圍,並避免將存在感與花費混淆。
原生廣告的花費數據是鎖定的。沒有網絡會公佈 Taboola、Outbrain、MGID 或 Revcontent 的廣告主在一個垂直領域投入了多少,也沒有像付費搜尋那樣的曝光份額 API。所以當媒體採購人員問「現在誰真正主導著原生廣告的金融領域?」時,過去誠實的回答只能是聳聳肩。
你可以在界定樣本中計算每個廣告主捕獲創意記錄的佔比。這是一項樣本存在感指標,而非對花費、曝光或整體市場聲量佔比的經驗證估計。
為了錨定我們談論的規模:截至 2026 年 6 月,OpenAdLibrary 已從 42 個網絡的 25,933 個廣告主捕獲了 589,036 個不同的創意,背後有 540 萬次廣告觀測記錄。這就是垂直領域聲量佔比分析所依據的原始材料。
原生廣告聲量佔比衡量什麼#
明確界定該指標:在指定的類別與收集窗口內,一個廣告主在捕獲創意記錄中的佔比,可選擇按不同的觀察日期加權。不要將首末之間的時間跨度稱為連續運行時間,也不要將加權視為持續投入的證明。
經典的聲量佔比有兩個淵源。最初來自電視和印刷媒體,是基於花費的:你的類別廣告花費除以總類別花費。數位時代增加了基於曝光的聲量佔比,平台直接提供曝光份額給你。原生廣告兩者都不提供。花費是隱藏的,也沒有曝光報告。你能看到的是廣告主在發佈商小工具上佔據的表面積,由原生廣告間諜工具捕獲。這個表面積就是代理指標的原始材料。
重複觀察可以幫助找出值得檢視的範例。它們並不確立廣告主是否賺了錢,或在兩次觀察之間是否持續投放。所引用的金融廣告是一個捕獲訊息的證據,而非對其稅務說法的驗證。

所引用的 2026 年 6 月分類報告了金融、保險與健康的計數。這些數字描述的是捕獲樣本,並不確立類別預算或整體市場競爭。
兩個信號,以及為什麼兩者都重要#
活躍創意數量#
使用有記錄的去重複規則與窗口,計算不同的捕獲創意數量。差異可能反映變體、收集覆蓋範圍或活動投放;它們並不直接衡量測試強度或規模。
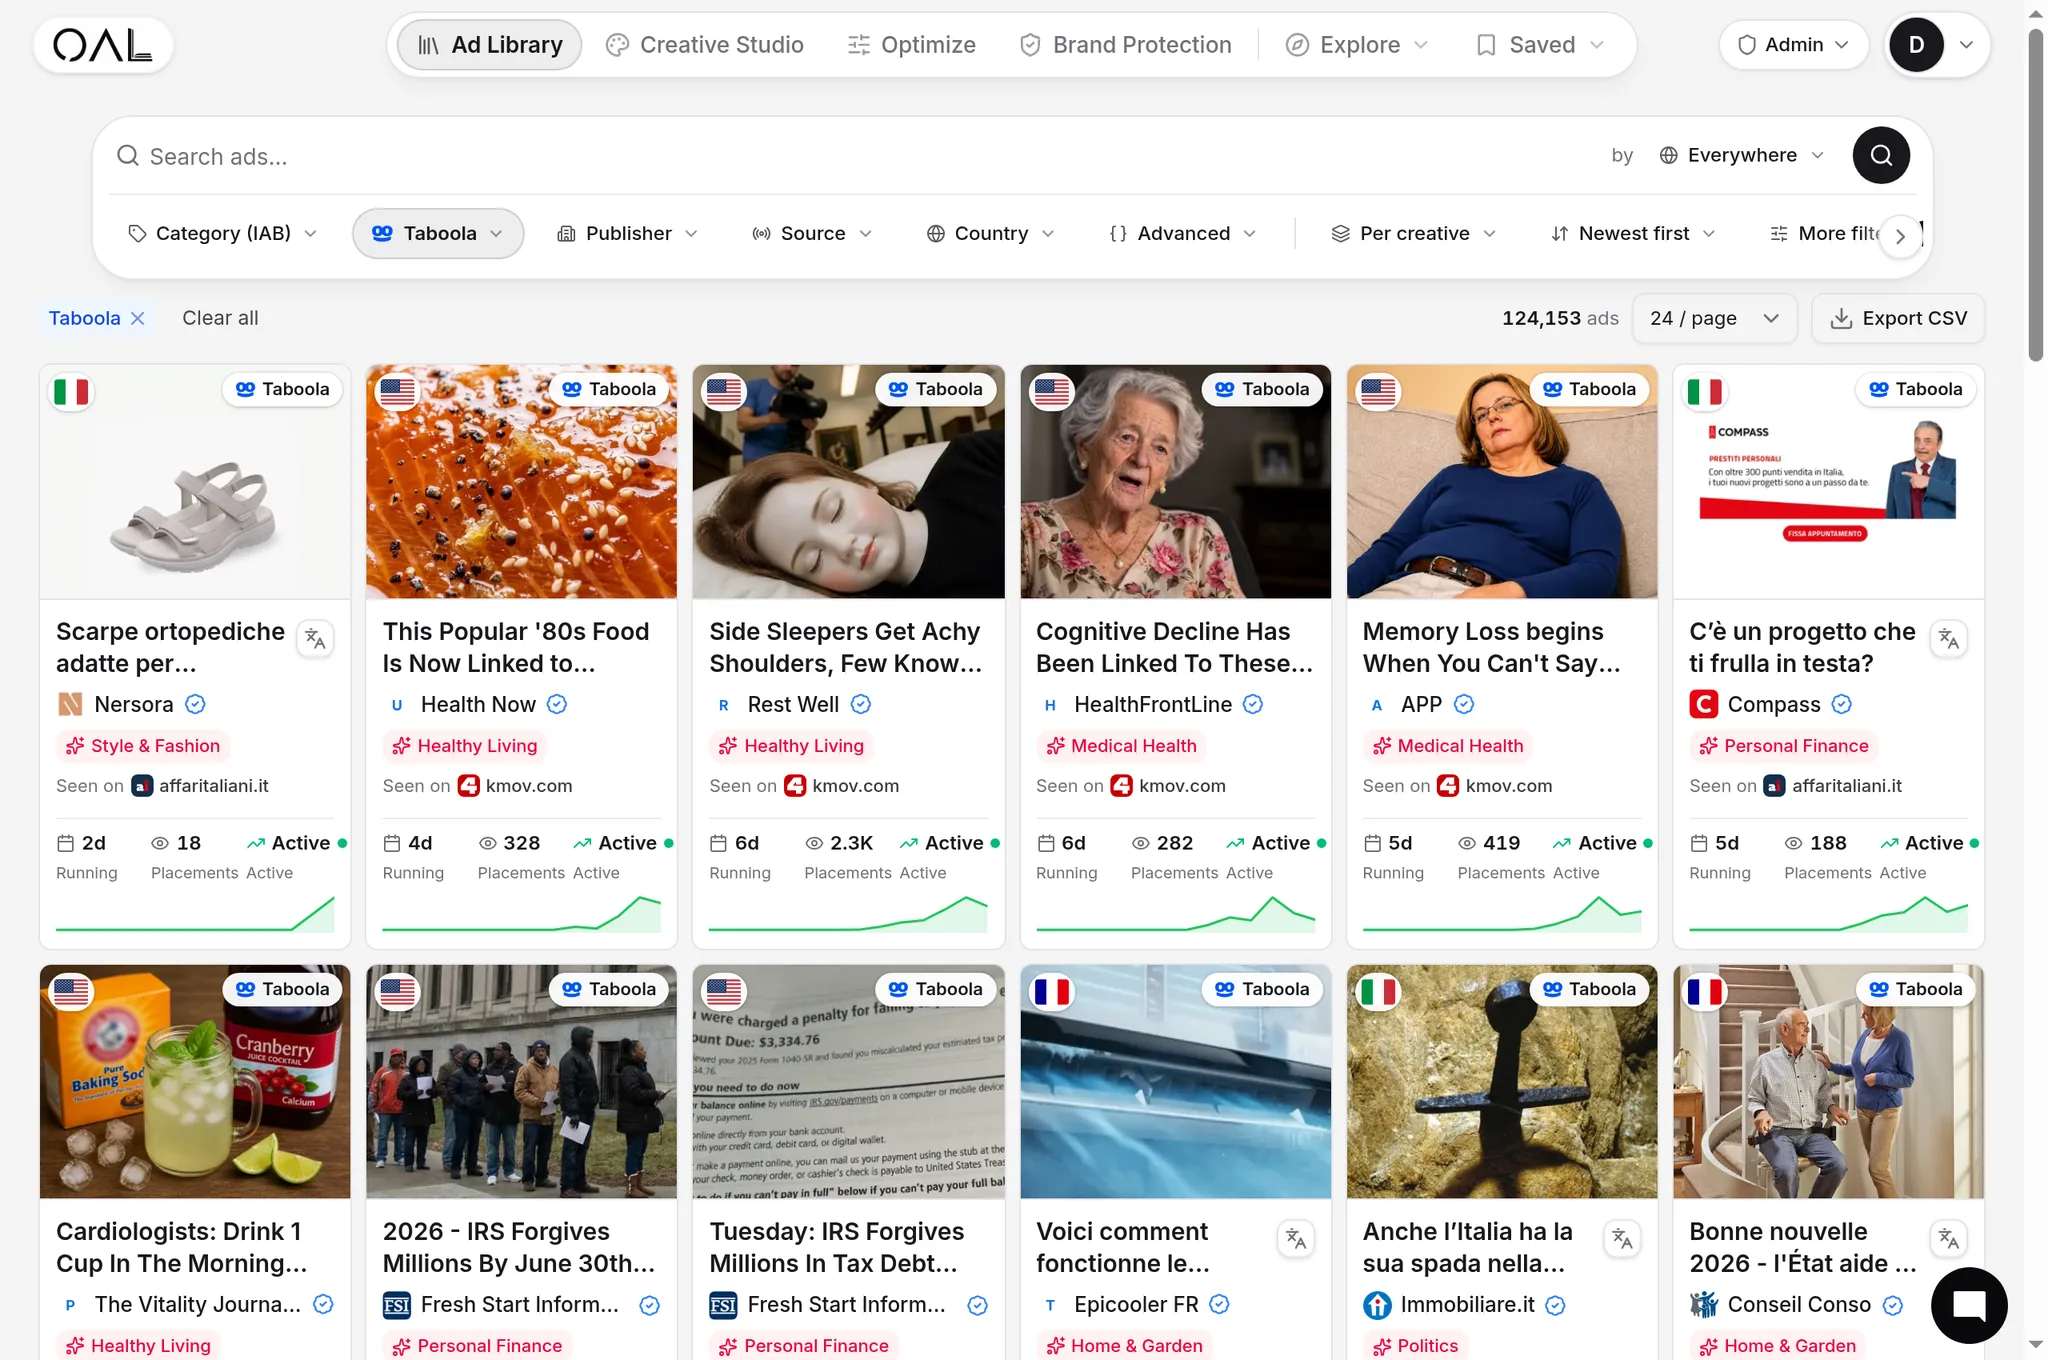
然而,僅看數量是可以被操縱的。有些廣告主會投放數十個幾天內就消失的一次性變體。原始數量獎勵了這種快速更替,並誇大了他們的實際影響力。你可以在像這樣的廣告中看到這種測試本能,這是一個新鮮的消費產品角度,可能存活也可能無法存活過第一週。

運行天數(按持久性加權的存在感)#
如果有每日觀察記錄,計算每個創意的不同觀察日期數量。將其與首末之間經過的時間跨度分開,因為後者可能包含沒有觀察的日子。兩者都不確立成效。
少數被重複觀察到的創意,可能比許多只被觀察一次的創意獲得更大的權重。這是所選公式的結果,而非盈利花費的證據。
說明觀察窗口與截尾。所引用快照中約 28 天的上限限制了可測量的範圍;這並不使觀察時間最長的範例成為經過驗證的贏家。該快照並未確立任何 90 天的結果。
一個可辯護的聲量佔比公式#
將兩者結合為一個單一、透明的分數。最簡單且經得起審查的版本是:
加權樣本存在感佔比(%)= 廣告主的不同觀察日期總和,除以所有範圍內廣告主的相同總和,再乘以 100。界定缺失日期、重複記錄與零分母的處理方式。如果只有首次/最後時間戳,應單獨報告觀察跨度分數,而不是稱其為觀察天數。
可以選擇對單個創意的運行天數貢獻設置上限,這樣一個古老的常青廣告就不會淹沒一個原本充滿活力的廣告主。並列報告原始創意數量和按運行天數加權的分數。兩者之間的差距本身就是一種診斷信息。
以下是五個(說明性,非實際測量)廣告主根據你信任哪個信號可能重新排名的情況:
說明性加權總數:A 1,820;B 1,240;C 1,050;D 980;E 760。總計為 5,850,得出四捨五入後的佔比 31%、21%、18%、17% 和 13%。這些虛構數值僅用於演示算術;它們不代表活動成效、盈利能力或 28 天同期組。
數量排名與加權存在感排名回答的是不同的問題。在未確立與預期結果之間的經驗證關係之前,兩者都無法識別真正的市場領導者。
定義垂直領域(這是大多數分析出錯的地方)#
聲量佔比的好壞取決於分母。如果垂直領域的邊界定義錯誤,每個百分比都是虛構的。定義垂直領域範圍的三種方法,按嚴謹度遞增排列:
- 按類別或 IAB 分類。 快速、粗略。適用於高層次的「金融」或「健康」,但在垂直領域重疊時效果較差(補充劑是「健康」還是「保健品」?)。關於粗略分類問題的視角:在我們的索引中,僅 Taboola 就顯示了 6,048 個健康創意和 5,558 個金融創意,而 Outbrain 則偏向金融優先(2,640 個金融,2,016 個健康)。同一個廣告主可能根據網絡和分類器落入不同的類別,這正是為什麼僅按類別定義範圍是最弱的方法。
- 按關鍵字和創意角度。 根據標題語言和使用的創意角度進行過濾。更緊密,但創意文案很混亂。兩個廣告可以用截然不同的鉤子銷售相同的產品。
- 按到達頁面目的地。 最強的信號。兩個文案不同但最終指向同一個產品頁面(或同一個預先到達頁面)的廣告屬於同一個競爭集群。
使用捕獲的到達頁面證據來協助將相關優惠分組,並手動檢視不明確的別名。到達頁面或追蹤器不一定能識別付費方或法律上的廣告主。不要點擊上線中的廣告來進行調查。

如何在 OpenAdLibrary 中自行運行此分析#
代理指標的全部意義在於它必須是可重現的。以下是端到端的工作流程:
- 定義垂直領域範圍。 按類別、關鍵字或(最好)到達頁面模式過濾廣告索引。決定哪些網絡計入(僅 Taboola 加 Outbrain?加上 MGID、Revcontent、Teads、MSN、Yahoo?)。記錄你的選擇。這是方法論的一部分。
- 設定觀察窗口。 聲量佔比是一個快照。對於快速變化的垂直領域,「過去 30 天內活躍」是一個合理的默認值;對於緩慢的季節性垂直領域,可以擴大窗口。
- 按廣告主分組。 使用解析後的廣告主身份,然後手動將已知的別名合併在一起。這個去重複步驟是真實排名與噪音之間的區別。
- 提取兩個信號。 每個廣告主的活躍創意數量和總運行天數。
- 計算和繪圖。 應用公式,可選擇對每個創意的運行天數設置上限,然後排名。繪製數量與運行天數聲量佔比的對比圖,讓差異凸顯出來。
- 對領先者進行合理性檢查。 打開頂級廣告主的創意。它們真的在你的垂直領域嗎?長期運行的廣告是真的在上線中還是過時的捕獲記錄?先信任,再驗證。
在存取與隱私限制的前提下,公佈重現該圖表所需的記錄與計算。缺失的追蹤、無法取得的素材或不完整的覆蓋範圍,必須保持可見,而不是被描述為完全可審計的證據。
聲量佔比代理指標能告訴你什麼,不能告訴你什麼#
牢記其局限性,以免過度宣稱:
限制:該指標描述的是捕獲記錄,而非花費或曝光;代表性未經驗證;地理位置、設備、來源與捕獲頻率都會影響覆蓋範圍;而最後出現並不證明目前仍在投放。在每次比較時都要同時說明這些限制。

這些限制可能改變排名。它們不是統計上的置信區間;要估計置信區間,需要合適的抽樣模型。
這對你的下一步行動為何重要#
使用該排名來挑選競爭對手與範例,以供進一步檢視。它並不識別盈利創意、可用版位或尚未被充分服務的市場。
想從實時、可引用的廣告捕獲數據,連同追蹤到到達頁面的真實廣告主和真實創意,建立你自己的垂直領域聲量佔比圖表嗎?免費開始:查看 20 個最新廣告,無需信用卡,然後從每月 $29.99 開始深入探索。
方法論說明:重新排名表中的數字是說明性的,旨在演示聲量佔比代理指標,而非實際測量結果。索引總數和垂直領域計數是真實的(OpenAdLibrary 索引,2026 年 6 月)。在你自己的垂直領域上運行工作流程以生成真實數字,並且在報告任何聲量佔比圖表時,始終同時說明你的網絡範圍、地理位置和設備、觀察窗口以及捕獲覆蓋範圍的注意事項。
來源:Brandwatch, 聲量佔比公式和範例, Search Engine Land, 聲量佔比指南, Taboola, 2026 年原生廣告平台。