English
 Español
 Português (Brasil)
 Français
 Deutsch
 Italiano
 Nederlands
 Polski
 Türkçe
 Русский
 日本語
 한국어
 简体中文
 Tiếng Việt
 Bahasa Indonesia
 繁體中文
 Čeština
 Dansk
 Norsk (bokmål)
 Suomi
 Ελληνικά
 Română
 Magyar
 Українська
 ไทย
 हिन्दी
 العربية
 עברית
Kan Konkurrenter Se Att Du Tittar På Deras Annonser? (Mestadels Nej, Så Här Fungerar Det)
Ett enda besök på en konkurrents annons eller landningssida identifierar dig inte. Här är vad som faktiskt visas i deras analys, vad som kan väcka annonsörernas misstanke och hur professionella forskningsverktyg undviker det.

Mestadels, nej. Att besöka en konkurrents annons eller landningssida identifierar dig inte personligen för dem, även om det kan kännas så. Vad det kan göra är att dyka upp som en avvikande datapunkt i deras analys (ett ovanligt besökmönster, ett avvisande utan konvertering, trafik från ett IP‑intervall eller en enhetsfingeravtryck de inte känner igen som en kund). Om det märks och om det kan spåras tillbaka till just dig beror på hur du surfar och hur sofistikerad deras setup är.
Vad en konkurrents analys faktiskt kan se#
Varje landningssida en konkurrent kör har vanligtvis analys och en tracking pixel kopplad, plus en conversion pixel längre ner i tratten. Från den stacken kan de se: din IP‑adress (som löser upp till en ISP, stad och ibland ett organisationsnamn om du är på ett företags‑ eller hosting‑provider‑nätverk), ditt enhets‑ och webbläsar‑fingeravtryck, hänvisningskälla och beteende på sidan som scroll‑djup och tid på sidan. Vad de inte kan se, från ett normalt annons‑klick eller sidbesök, är ditt namn, din arbetsgivare eller att "en konkurrent" tittade på deras annons, såvida inte något i ditt trafikmönster avslöjar det.
Vad som faktiskt väcker annonsörernas misstanke#
- En företags‑ eller hosting‑provider‑IP‑adress. Om ditt företags utgående trafik löser upp till en namngiven organisation i analysen (vanligt med kontorsnätverk och vissa VPN‑er), och den organisationen är en konkurrent, märker skarpa annonsörer ibland detta, särskilt om samma organisation visar upprepade besök utan köp.
- Upprepade besök utan konvertering, från samma fingeravtryck. Ett besök är brus. Tio besök över två veckor från ett webbläsar‑fingeravtryck som aldrig konverterar är ett mönster som grundläggande analysverktyg automatiskt visar.
- Fyll i ett lead‑formulär med riktiga eller uppenbart falska uppgifter. Detta är det snabbaste sättet att bli flaggad, och det kan också trigga ett telefonsamtal eller en retargeting‑kampanj riktad direkt mot dig. Gör det inte för forskning.
- Besök via en länk som annonsören kontrollerar, med spårningsparametrar intakta, såsom att klicka på deras retargeting‑annons eller en e‑postlänk, snarare än att nå landningssidan självständigt.
Varför cloaking finns och hur det hänger ihop med detta#
Vissa annonsörer, särskilt i gråzon‑vertikaler, kör ad cloaking: de visar en landningssida för riktiga potentiella kunder och en annan, ofta enklare eller mer efterlevnads‑vänlig sida för alla som ser ut som en granskare, en bot, en annons‑nätverk‑crawler eller en konkurrents forsknings‑IP. Cloaking triggas vanligtvis av exakt de signaler som nämns ovan (datacenter‑IP‑er, kända crawler‑user‑agents, geo‑mismatch) snarare än av att identifiera en specifik forskare. Om du någonsin landat på en sida som såg märkbart enkel ut jämfört med annonsen som ledde dig dit, är det sannolikt vad som hände. Vi går djupare in på mekaniken i how ad cloaking works, inklusive signalerna som skiljer legitim personalisering från avsiktlig undvikelse.
Retargeting är en separat mekanism, och den följer dig#
Det finns en sak som faktiskt "märker" dig, men inte genom att identifiera dig som en konkurrent: retargeting. Om du klickar på en konkurrents annons eller landar på deras sida, kan deras tracking pixel lägga till din webbläsare i en retargeting‑publik, och du kan börja se deras annonser igen på andra webbplatser och nätverk i dagar eller veckor efteråt. Detta är inte att de singlar ut dig, det är samma mekanism som följer varje besökare som inte konverterar. Det kan kännas som att du blivit upptäckt, men det är automatiserat och o‑personligt på individnivå. Om detta stör dig under forskning, stoppar du det genom att surfa i ett privat fönster eller rensa cookies mellan sessioner.
Native‑annonsnätverk lägger till ett geo‑lager till detta#
På native‑nätverk specifikt passerar redirect chain från annonsklick till slutlig landningssida ofta genom geo‑targeting‑logik, eftersom contextual targeting och geo targeting bestämmer vilket kreativt material och erbjudande du ser först. Om du forskar på en US‑inriktad kampanj från en icke‑US‑IP, kan du helt enkelt aldrig se den riktiga annonsen, inte för att du flaggats, utan för att du ligger utanför målgruppsreglerna. Detta är en mycket vanlig orsak till "Jag kunde inte reproducera vad någon annan såg" snarare än någon form av individuell detektering, och det är därför tvär‑geo‑forskning vanligtvis kräver surfning från inom mål‑geo snarare än att försöka lura ett system som bara följer sin målgruppskonfiguration.
Hur professionella forskningsverktyg hanterar detta#
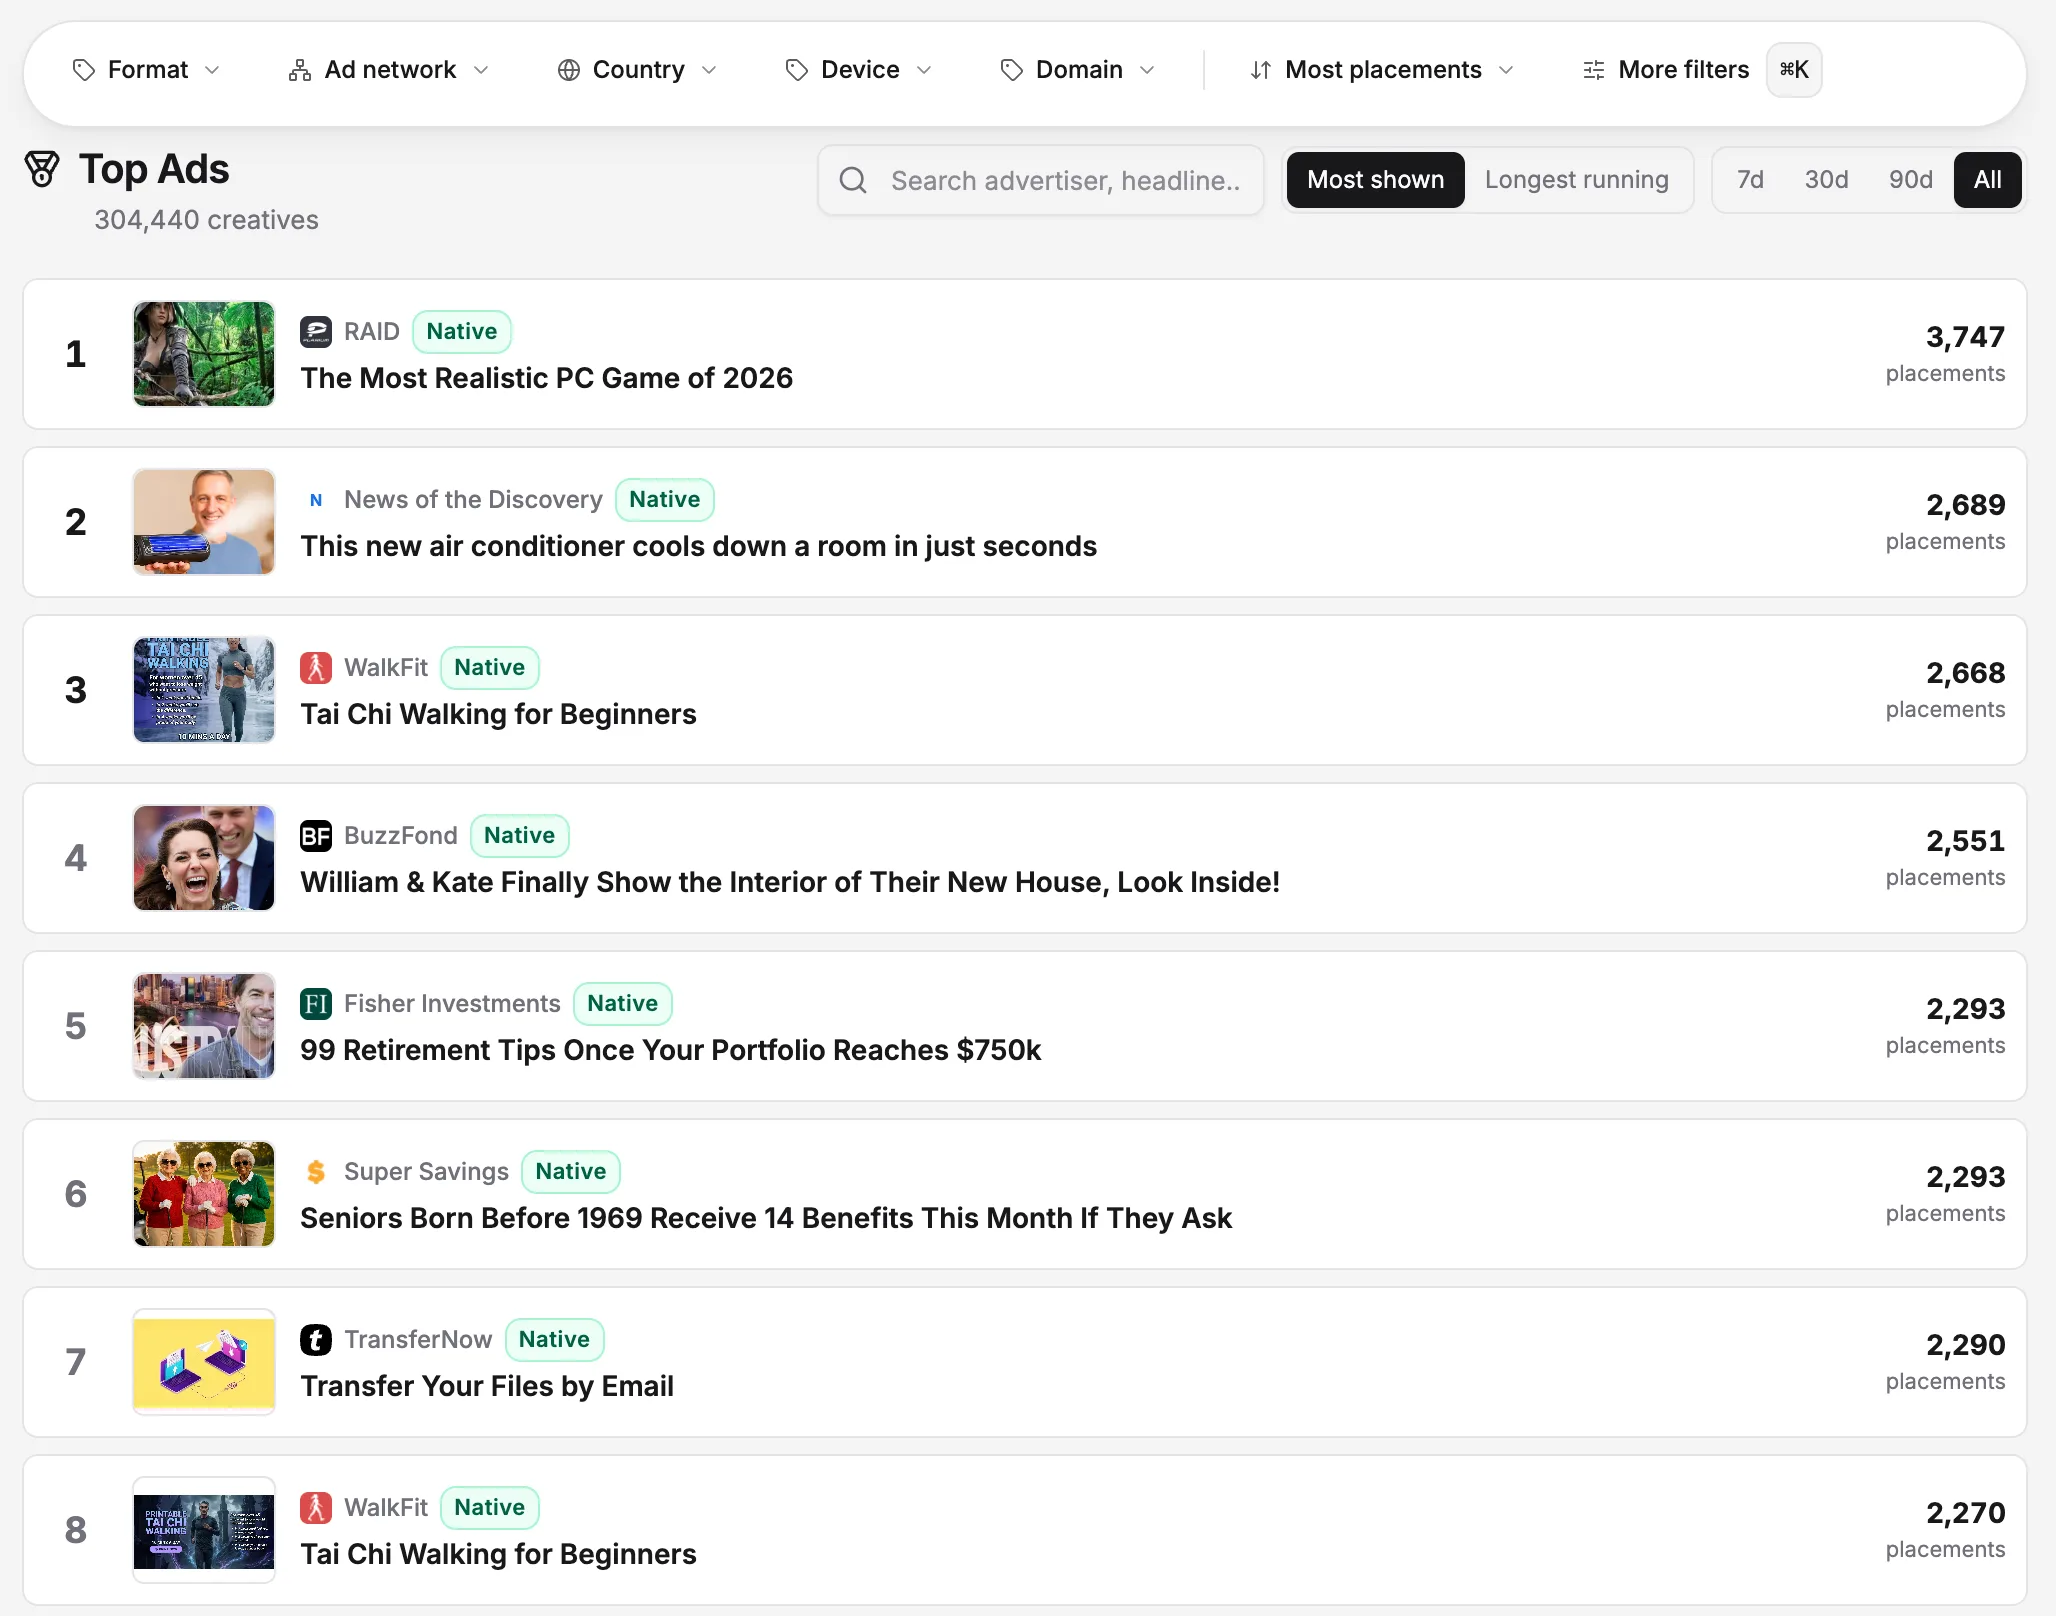
Allvarliga ad‑intelligence‑plattformar surfar inte från en kontors‑IP eller en personlig bostadsanslutning när de fångar annonser i skala, av samma anledning som en mystery shopper inte bär ett namnbricka. Genom att använda en spridning av roterande, geografiskt distribuerade IP‑er som liknar vanlig konsumenttrafik håller man fångsten från att bli den avvikande datapunkten som triggar en annonsörs bedrägeri‑ eller cloaking‑filter, och det betyder att annonsen och landningssidan du ser är densamma som en riktig prospekt i den geo‑n skulle se, inte en sanerad version som serveras till en misstänkt forskare. OpenAdLibrary's ad intelligence plattform är byggd kring denna typ av fångst över 49 nätverk, exakt så att det kreativa materialet och redirect‑kedjan du tittar på speglar vad som faktiskt är live, inte en cloaked‑substitut.
Vad serverloggar visar som dashboard‑analys inte gör#
Det mesta av diskussionen ovan förutsätter att annonsören tittar på en standard dashboard‑analys, som aggregerar och anonymiserar mycket av det som tekniskt är tillgängligt. Rå serverloggar, om någon faktiskt läser dem, innehåller mer: fullständiga IP‑adresser, exakta tidsstämplar, user‑agent‑strängar och request‑headers för varje enskild träff, inte bara konverteringar. I praktiken granskar nästan ingen manuellt råa loggar för en native‑ eller affiliate‑landningssida; det är inte värt analytikerns tid för de flesta kampanjer. Där det görs är vid bedrägeriforskning, när en annonsör ser en spik i klick utan motsvarande konverteringar och drar loggar för att ta reda på varför. Om din forskning innebär att du klickar på en annons upprepade gånger snarare än att bara visa en fångad kopia, är det scenariot som mest sannolikt placerar din trafik under ett mikroskop, och det har inget att göra med att någon känner igen dig som en specifik konkurrent.
Praktiska steg om du forskar manuellt#
Om du själv kontrollerar konkurrents annonser snarare än via en plattform, finns några vanor som håller din forskning osynlig utan att göra något bedrägligt:
| Gör | Undvik |
|---|---|
| Surfa från en bostads‑ eller mobilanslutning | Surfa från en uppenbar kontors‑ eller datacenter‑IP |
| Titta, ta skärmdump och gå vidare | Fyll i lead‑formulär eller ange riktiga kontaktuppgifter |
| Variera tider och dagar du kontrollerar | Kontrollera samma annons från samma IP dagligen i veckor |
| Använd ett privat eller nytt webbläsarfönster | Stanna inloggad på ditt eget företags verktyg medan du surfar |
Inget av detta handlar om att dölja något oetiskt. Du får titta på offentliga annonser, och det är rutinmässig branschpraxis; se vår översikt av whether spying on competitor ads is legal för de gränser som faktiskt betyder något, främst kring skrapningsmetoder och utgivning, inte kring att bara se vad som offentligt serveras.
Den större bilden: detta spelar sällan så stor roll som det känns#
De flesta annonsörer optimerar för konverteringsgrad och kostnad per klick, inte för att övervaka sin analys för en rivalens fingeravtryck. Såvida du inte triggar ett lead‑formulär, är inloggad på ett igenkännbart företagsnätverk eller besöker samma sida från samma IP dagligen, är du statistiskt brus i deras dashboard, inte ett flaggat händelse. Den större praktiska risken är inte detektering, utan annons‑cloaking eller copycat landing pages som tyst visar dig något annat än vad riktig trafik ser, vilket är ett datakvalitetsproblem för din forskning, inte ett integritetsproblem för dem.
Tillbaka till vad du egentligen försöker lära dig#
Det underliggande målet i nästan alla fall är detsamma: se den riktiga annonsen, den riktiga landningssidan och det riktiga erbjudandet, över vilken geo och enhet annonsören faktiskt riktar sig, utan att versionen du ser förändras på grund av hur du kom dit. Det är ett problem med dataintegritet, inte ett stealth‑problem, och det är värt att behandla så. Att jaga anonymitet för anonymitetens skull tenderar att distrahera från den faktiska forskningsfrågan, som vanligtvis är "vad är den här konkurrentens vinkel, och fungerar den", inte "märkte de mig". Svara på den andra frågan genom att vara oansenlig (bostadsanslutning, inga upprepade manuella klick, inga formulärifyllningar), och lägg resten av din uppmärksamhet på den första.