English
 Español
 Português (Brasil)
 Français
 Deutsch
 Italiano
 Polski
 Svenska
 Türkçe
 Русский
 日本語
 한국어
 简体中文
 Tiếng Việt
 Bahasa Indonesia
 繁體中文
 Čeština
 Dansk
 Norsk (bokmål)
 Suomi
 Ελληνικά
 Română
 Magyar
 Українська
 ไทย
 हिन्दी
 العربية
 עברית
Hoe Native Ad Targeting Werkt (Contextueel, Interesse & Post-Cookie)
Native ad targeting is niet één mechanisme, het zijn vijf of zes overlappende lagen: contextueel, interesse, retargeting, geo, device en planning. Hier lees je hoe elke laag daadwerkelijk werkt.

Native ads targeten gebruikers via een mix van contextuele signalen (de pagina en categorie die ze op dat moment lezen), first‑party audience data die het netwerk al bezit (device, geo, browse‑geschiedenis binnen zijn eigen publisher‑netwerk), en adverteerder‑geleverde inputs zoals retargeting‑pixels en look‑alike segmenten, die via een real‑time veiling worden uitgevoerd in plaats van een vaste plaatsingskoop. Er bestaat geen enkel "native targeting"‑mechanisme; het is een stapel overlappende opties, en hoeveel gewicht elke optie krijgt hangt af van het netwerk en het campagnedoel.
Contextuele targeting: de oudste laag, nu de meest veerkrachtige#
Elk native network laat je targeten op content‑categorie en trefwoord: financiële artikelen, gezondheidscontent, autobeoordelingen, enzovoort. Dit is de minst invasieve vorm van targeting omdat er niets over de individuele gebruiker hoeft te worden weten, alleen wat hij/zij op dat moment leest. Het is bovendien de laag met de meeste blijvende kracht geworden nu third‑party cookies worden beperkt, omdat contextual targeting helemaal niet leunt op cross‑site identifiers.
Contextuele targeting op native netwerken gaat meestal dieper dan een brede categorie. Taboola en Outbrain bieden beide site‑ en sectie‑level targeting, zodat je specifiek kunt bieden op een uitgevers health‑vertical of zijn personal‑finance sectie in plaats van op het volledige domein. Die granulariteit is vaak een betere hefboom dan audience‑targeting voor adverteerders in gereguleerde categorieën, omdat het direct het adjacency‑risico beheerst.
Interesse‑ en gedrags‑targeting#
Naast context bouwen netwerken interesse‑profielen op basis van browse‑gedrag binnen hun eigen publisher‑footprint (wat een gebruiker leest, klikt en waar hij/zij blijft hangen op de sites in het netwerk). Dit is first‑party data vanuit het perspectief van het netwerk, ook al omvat het vele uitgeversdomeinen, omdat het wordt verzameld onder de eigen trackingrelatie van het netwerk met die sites. Het wordt gebruikt om brede interesse‑segmenten (auto‑intenders, travel‑researchers, health‑content lezers) te bouwen die adverteerders bovenop context‑ en geo‑targeting kunnen leggen.
Retargeting: pixel‑gebaseerd, en nog steeds de hefboom met de hoogste intentie#
Plaats een pixel van het netwerk op je site en je kunt bezoekers die niet hebben geconverteerd retargeten met native placements terwijl ze elders binnen dat netwerk browsen. Dit blijft een van de sterkste hefbomen in native omdat het gebaseerd is op een directe first‑party relatie (je eigen pixel, je eigen bezoeker), niet op een third‑party cookie‑grafiek. Het is ook de reden dat native retargeting relatief geïsoleerd is gebleven van de cookie‑deprecatie‑discussies die display en social het hardst hebben geraakt.
Geo, device en dayparting#
Dit zijn basisvereisten bij elk netwerk: land en vaak regio/plaats‑level geo targeting, device‑type (desktop, mobiel, tablet) en OS, verbindingstype op mobiel, en tijd‑van‑dag/dag‑van‑week planning. Niets hiervan hangt af van identity resolution, wat een van de redenen is dat native campagnes minder blootgesteld zijn aan identifier‑verlies dan programmatic display aankopen die leunen op bid‑stream data.
| Targeting layer | Depends on cookies/IDs? | Typical use |
|---|---|---|
| Contextual (category, keyword, site/section) | No | Brand safety, vertical relevance, cold prospecting |
| Interest/behavioral (network's own data) | Partially, first-party | Broader reach within a relevant audience |
| Retargeting (advertiser pixel) | First-party pixel, not third-party cookie | Highest-intent remarketing |
| Geo, device, dayparting | No | Baseline scoping on every campaign |
| Lookalike/similar audiences | Built from first-party seed data | Scaling a proven converting audience |
Wat "post‑cookie" hier eigenlijk verandert#
De onderdelen van native targeting die het meest blootgesteld waren aan third‑party cookie‑deprecatie waren altijd de dunste laag: cross‑site gedragsprofielen die buiten de eigen data van één netwerk werden samengevoegd. Native netwerken waren minder afhankelijk van die aanpak dan open‑web display programmatic, omdat een groot deel van de native targeting stack (context, netwerk‑eigendom interest data, adverteerder‑pixels, geo/device) nooit een gedeelde third‑party identifier nodig had. Dat is een van de redenen waarom native als kanaal standhoudt terwijl sommige display‑ en social ID‑gebaseerde targeting ruisiger is geworden. Cohort‑style en probabilistische benaderingen vullen de resterende gaten, maar het eerlijke antwoord is dat de meeste native kopers hun targeting‑playbook niet zo sterk hoefden aan te passen als programmatic display kopers.
Audience marketplace segmenten en third‑party data partnerschappen#
Sommige netwerken voegen third‑party audience segmenten toe via data‑management‑platform partners, waardoor adverteerders kunnen targeten op categorieën zoals "in‑market for auto insurance" of "recently searched travel deals" die door externe data providers zijn gebouwd in plaats van door de eigen first‑party observatie van het netwerk. Deze segmenten zijn doorgaans duurder en, eerlijk gezegd, minder consistent dan de native context‑ en retargeting‑tools van het netwerk, omdat de onderliggende methodologie per provider verschilt en niet altijd in detail wordt onthuld. Beschouw third‑party segmenten als een testbare extra laag, niet als een fundering; voer een controle uit tegen alleen context‑targeting voordat je een betekenisvol budget eraan toewijst.
Een concurrent's targeting van buitenaf lezen#
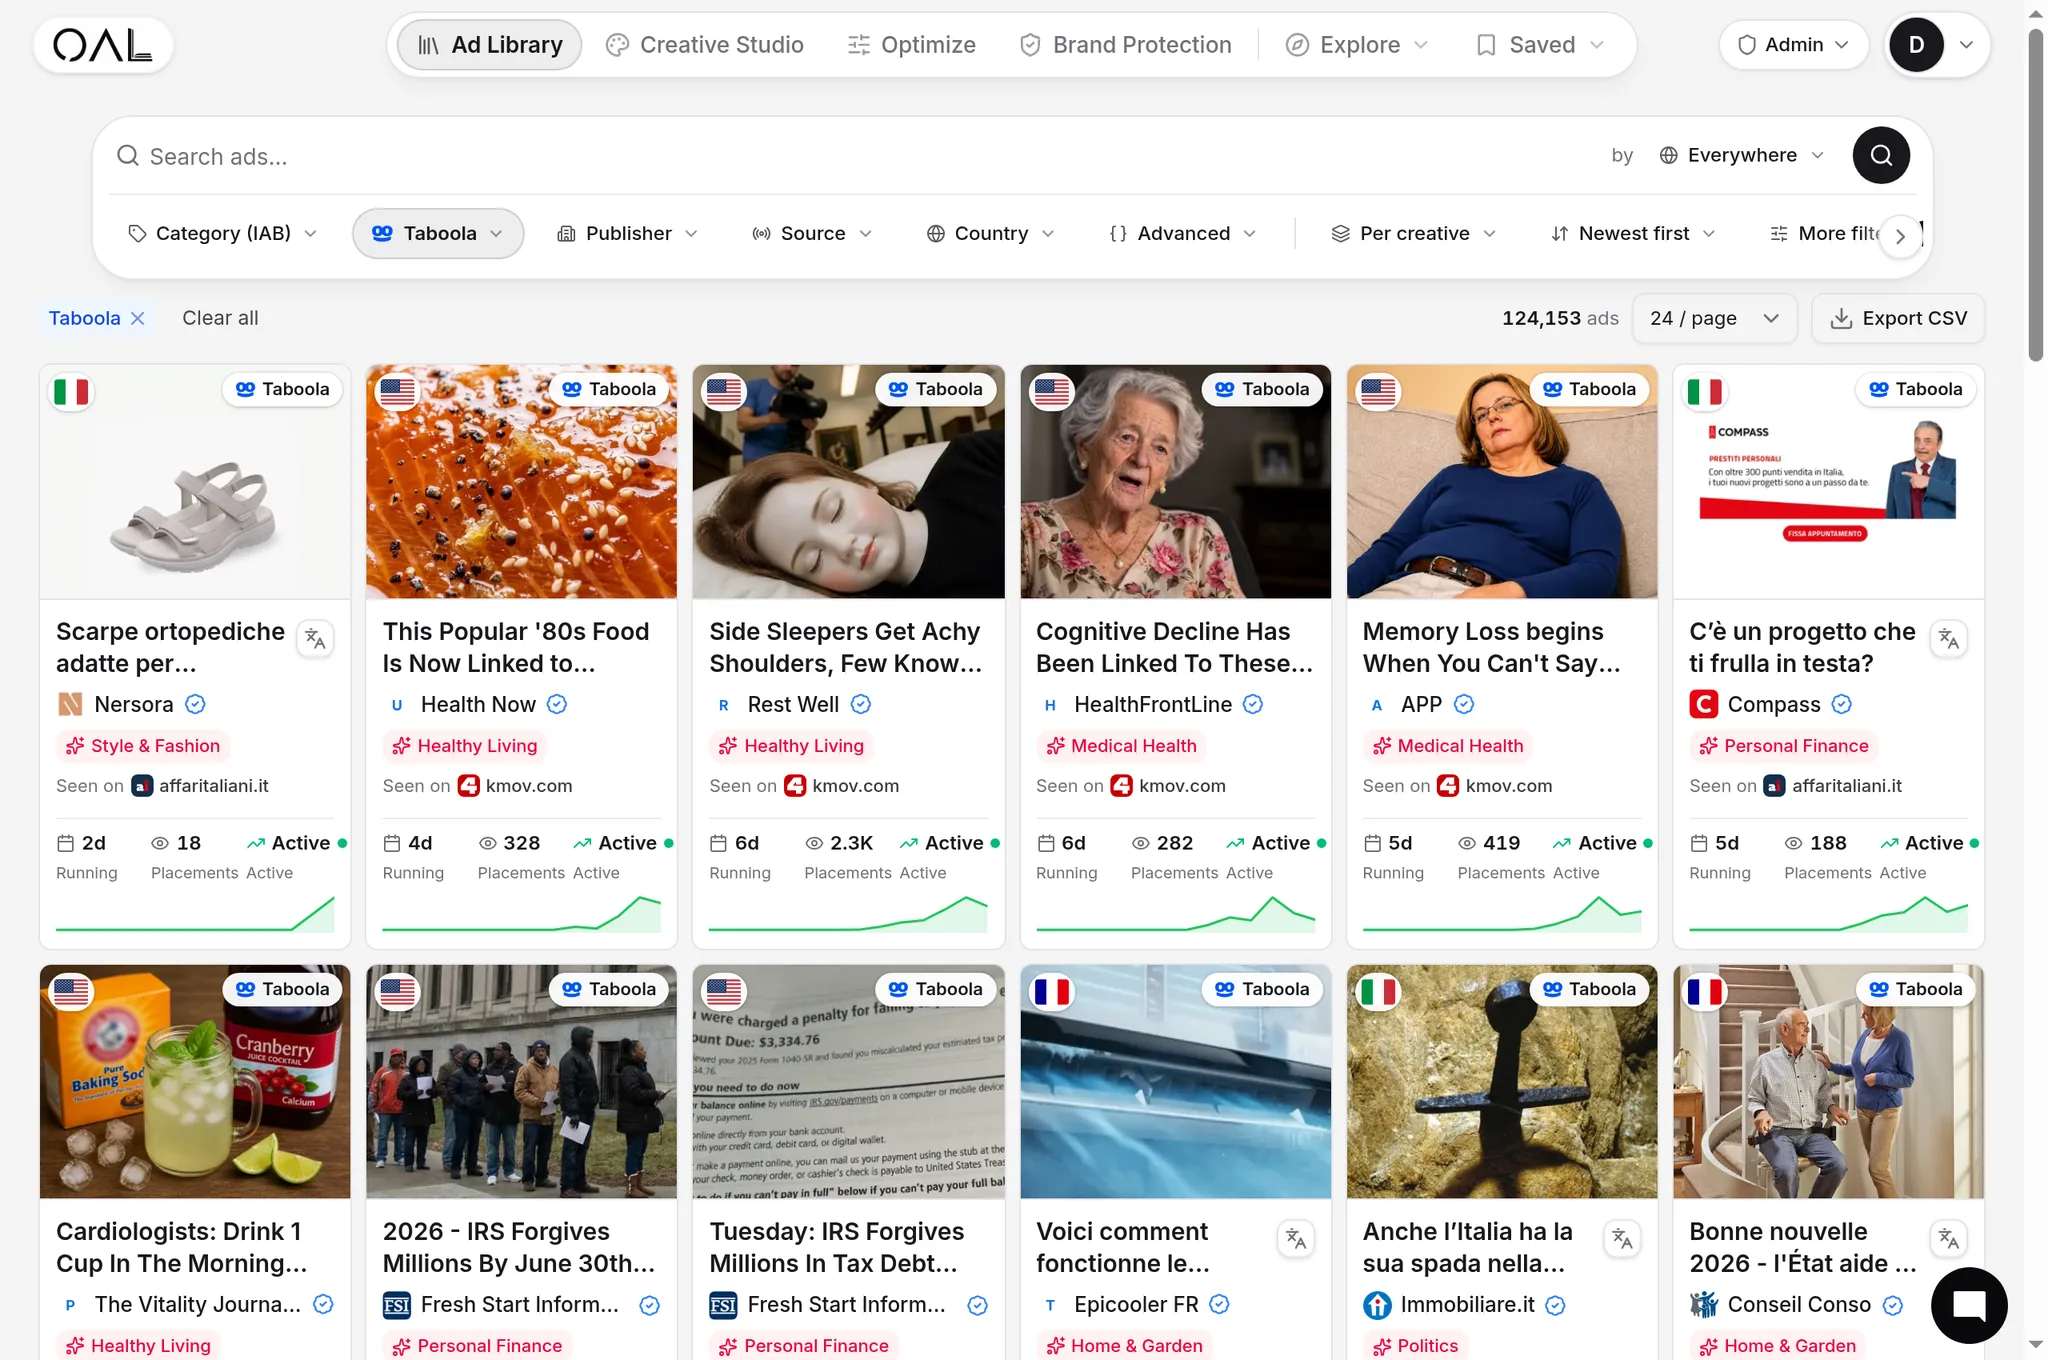
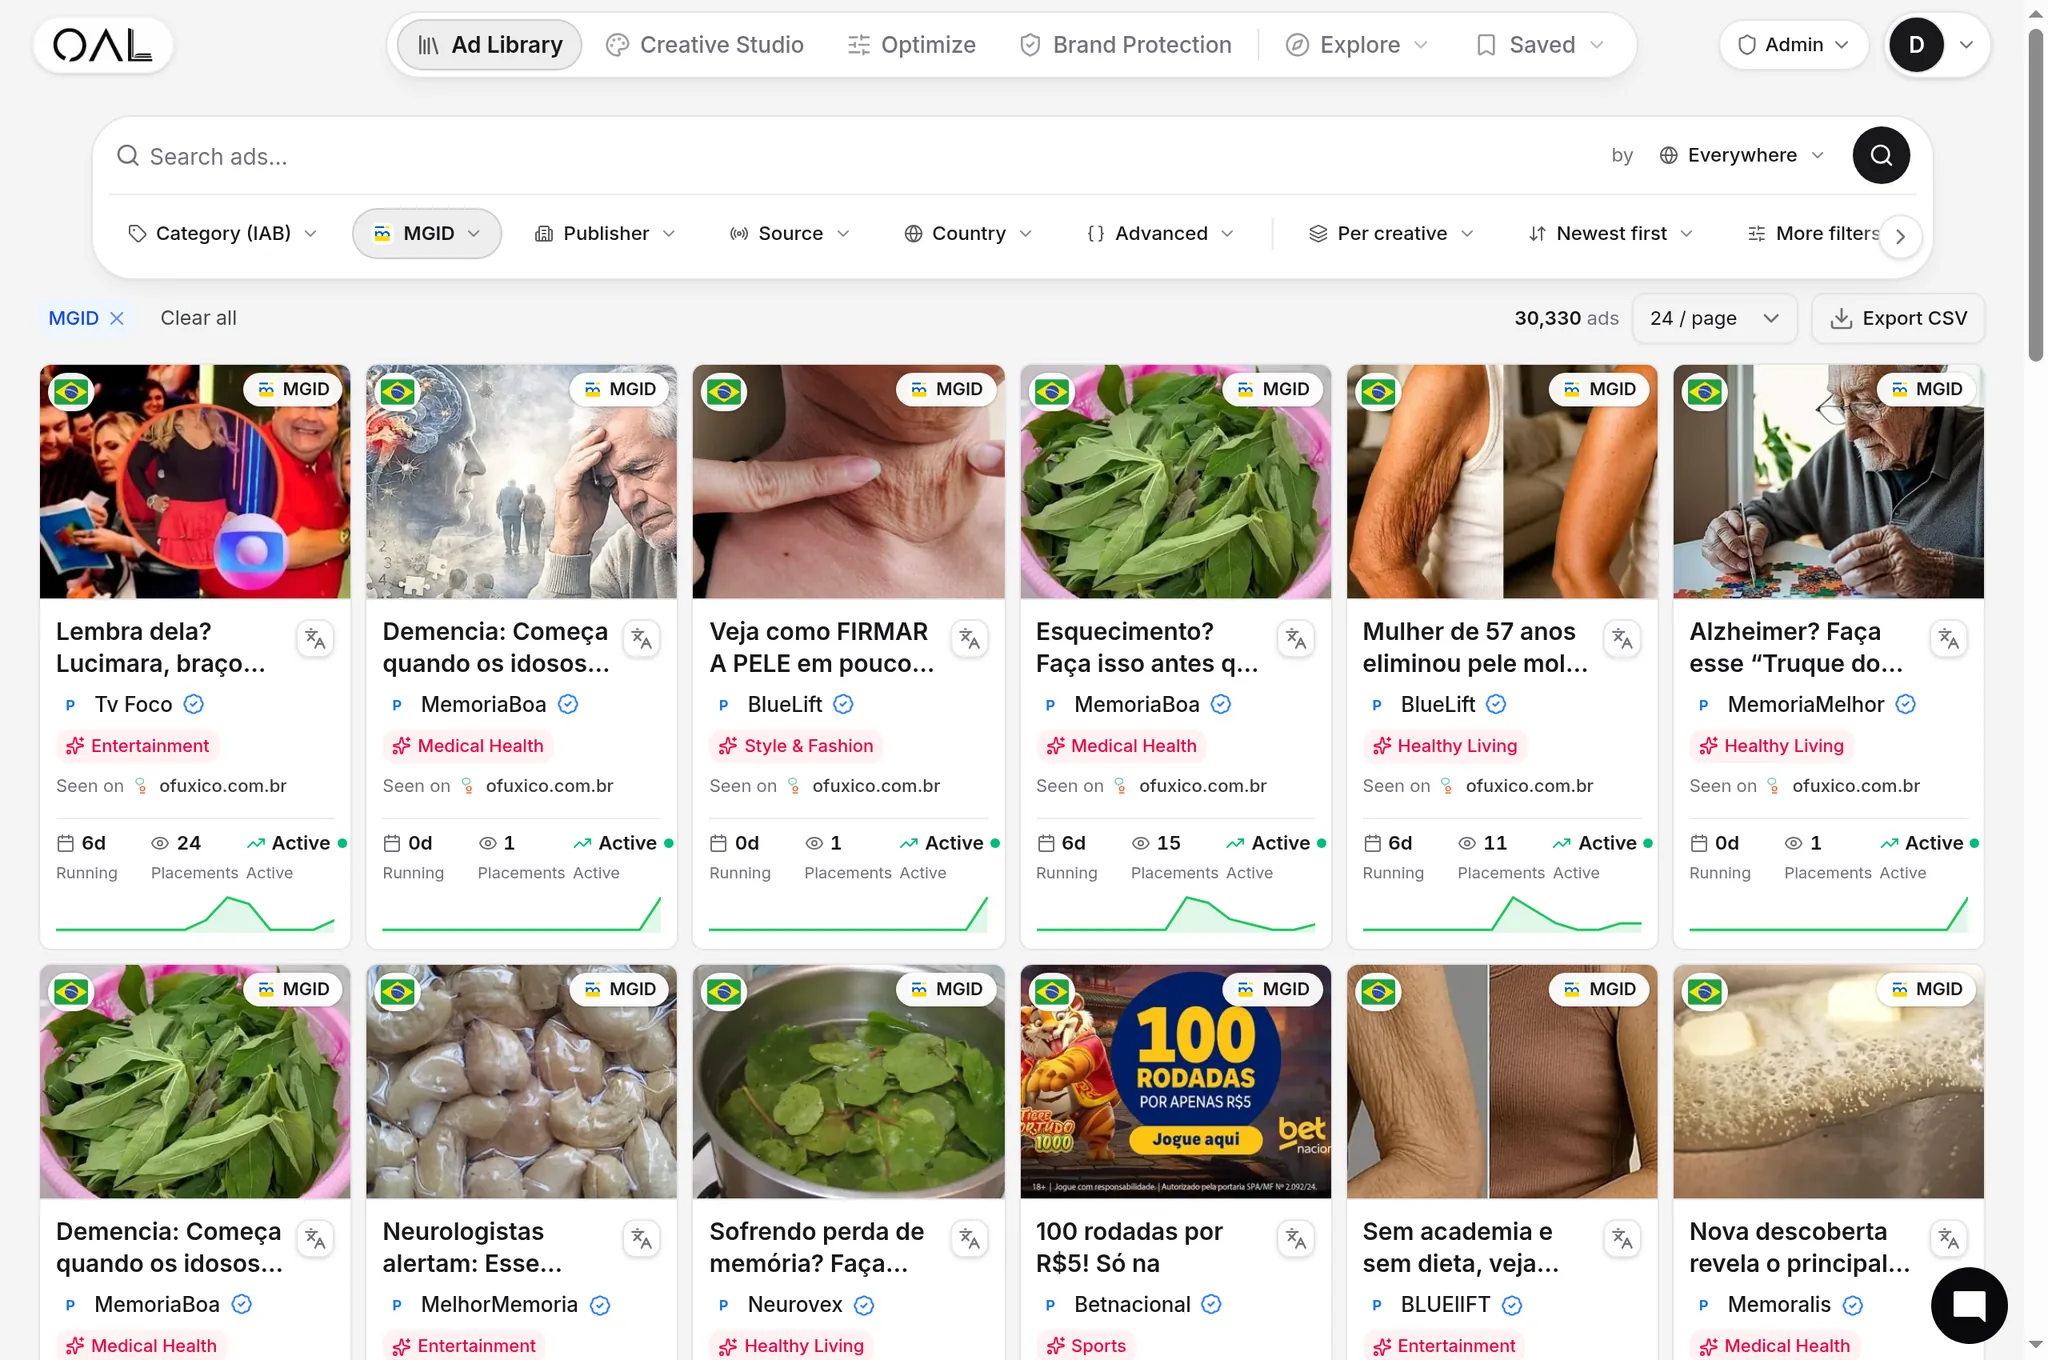
Je kunt de exacte segmentinstellingen van een concurrent niet zien, maar je kunt veel afleiden uit wat er daadwerkelijk draait: welke geo’s en devices een advertentie toont, op welke uitgeversverticalen hij zich concentreert, en hoe lang hij overleeft, wat meestal een proxy is voor of de targeting en creatieve samenkomen op een werkend publiek. Dit wordt dieper behandeld in onze gids voor media buying for native ads. Onze netwerkspecifieke gidsen over how Taboola ads work, how Outbrain works, en how MGID native ads work ontleden elk netwerk’s specifieke targeting‑menu en veilingmechanica, en ons artikel over scaling to new geos behandelt hoe geo‑targeting keuzes veranderen naarmate een campagne uitbreidt naar tier‑2 en tier‑3 markten.
OpenAdLibrary's ad intelligence index volgt de geo, device en vertical footprint van elke vastgelegde creatieve, zodat je in plaats van te gokken op de targeting‑strategie van een concurrent het daadwerkelijke patroon kunt zien: in welke landen een advertentie live is, of deze alleen mobiel is of overal draait, en hoe dat is verschoven sinds de eerste verschijning.
Lookalike en similar‑audience targeting#
Zodra een retargeting‑pixel of een custom audience list genoeg volume heeft, kunnen de meeste netwerken een look‑alike segment bouwen: gebruikers waarvan het browse‑gedrag lijkt op dat van je converters, zonder dat hun identiteit individueel moet worden opgelost. Dit is waar native targeting begint te lijken op wat sociale platforms al jaren bieden, behalve dat de seed‑data meestal kleiner is (pixel‑fires van één adverteerder) in plaats van platform‑brede gedragsgrafieken. Lookalikes werken het best als een schaal‑hefboom nadat je al een converteerbare kern‑audience hebt gedefinieerd via context en retargeting; gebruikt als een cold‑prospecting tool met een dunne seed‑list, presteren ze vaak minder goed dan rechttoe rechtaan context‑targeting.
Hoe targeting interacteert met de veiling, niet alleen bereik#
Het is makkelijk om te denken dat targeting alleen een audience‑filter is, maar op native netwerken verandert het ook je effectieve kosten. Nauwkeurigere, relevantere targeting (een specifieke uitgeverssectie, een warm retargeting‑pool) betekent meestal dat je concurreert met minder adverteerders voor dezelfde impressie, wat je effectieve CPC kan verlagen nog vóór de creatieve kwaliteit wordt meegewogen. Brede targeting bereikt meer mensen maar plaatst je in een grotere veilingpool, vaak met adverteerders die op volume bieden in plaats van relevantie. Dit is een reden waarom smalle context‑ en retargeting‑first strategieën vaak beter presteren dan brede bereik‑campagnes op een zuivere ROAS‑basis, zelfs als het ruwe impressie‑volume op papier kleiner lijkt.
Waar adverteerders het fout doen met targeting#
Twee fouten komen steeds terug in native accounts. De eerste is het stapelen van te veel restrictieve lagen tegelijk op een nieuwe campagne: strakke geo, een smal interesse‑segment en een kleine whitelist van uitgevers, waardoor het algoritme niet genoeg volume krijgt om van te leren en de kosten blijvend hoog blijven. De tweede fout is het tegenovergestelde: vanaf dag één breed gaan op elke dimensie omdat "we optimaliseren later", waardoor budget wordt verbrand op duidelijk irrelevante placements voordat het account enige signalen heeft. De betere volgorde is meestal geo en device eerst (goedkoop om goed te krijgen, duur om fout te krijgen), daarna context, en vervolgens retargeting en interesse‑uitbreiding zodra je een basis van echte prestatie‑data hebt om op te reageren.
Praktische conclusie#
Native targeting is geen enkele draaiknop, het zijn vijf of zes onafhankelijke knoppen (context, netwerk‑interest data, je eigen pixel, geo, device, planning) die je combineert, en de winnende combinatie verschilt per vertical. Adverteerders in health en finance leunen het zwaarst op sectie‑level contextuele targeting omdat adjacency en compliance daar meer wegen. Ecommerce leunt meer op retargeting en lookalikes omdat koopintentie makkelijker te vangen is met een pixel. Begin met context en geo om een veilige basis te leggen, voeg retargeting toe zodra je pixel genoeg volume heeft, en beschouw interest‑segmenten als een bereik‑hefboom zodra de kern al converteert.